Reducir tiempo de respuesta en fintech con IA sin comprometer compliance
Aivi · 30 Ago 2026 · 3 min de lectura
En fintech, "responder rápido" y "responder correcto" no siempre van de la mano — y elegir mal entre los dos sale caro. Un chatbot mal implementado que improvisa respuestas sobre comisiones, requisitos o procesos puede generar una queja formal, no solo un cliente molesto. La meta no es responder más rápido a cualquier costo: es eliminar la espera en lo que sí se puede automatizar sin tocar la parte sensible.
El problema real: el volumen bajo es el que más se descuida
Las fintech suelen invertir en atención para los volúmenes grandes (call center, ticketing) pero dejan sin resolver las preguntas de bajo volumen y alta repetición: "¿cómo reporto una tarjeta perdida?", "¿cuáles son las comisiones actualizadas?", "¿cómo cierro mi cuenta?". Son pocas por cliente, pero se repiten todos los días, y hoy consumen tiempo de un equipo que podría estar resolviendo casos que sí requieren criterio.
Qué se puede automatizar sin comprometer nada
Todo lo que sea información pública y estable: comisiones publicadas, requisitos documentales, pasos de un proceso (cómo reportar, cómo solicitar, cómo cancelar), horarios y canales de contacto. El asistente responde con exactamente esa información, la misma para todos, sin margen para una respuesta distinta según quién pregunte — lo cual, en un contexto regulado, es una ventaja de consistencia, no solo de velocidad.
Qué se mantiene 100% humano
Cualquier cosa sobre el estado o los datos de una cuenta específica, decisiones de riesgo o aprobación, y cualquier queja formal. El asistente identifica estos casos y los escala de inmediato con el contexto de la conversación, en vez de intentar resolverlos — reduce el tiempo hasta que un humano lo atiende, que es la métrica que de verdad importa en esos casos, no el tiempo de una respuesta automática genérica.
flowchart TD
    A["Consulta entrante"] --> B{"¿Info pública/estable? (comisiones, requisitos, proceso)"}
    B -->|Sí| C["Responde automático, mismo dato para todos"]
    B -->|"No, cuenta específica o riesgo"| D["Escala de inmediato con contexto"]
    D --> E["Atendido por humano, más rápido que antes"]
Cómo es la implementación
- Diagnóstico. Se separan las preguntas puramente informativas de las que requieren datos de cuenta o criterio de riesgo.
- Implementación. Se carga solo la información pública/estable, con reglas explícitas de cuándo escalar.
- Puesta en marcha. El asistente responde en producción, con cada interacción registrada y auditable.
- Mejora continua. Se revisa qué se está escalando de más (para automatizar) y qué se está automatizando de más (para corregir).
Cuánto cuesta
Implementación desde $14,000 MXN, más mensualidad desde $2,500 MXN (hasta 1,000 conversaciones) o $4,900 MXN para volumen ilimitado con reportes de uso y costo.
Preguntas frecuentes
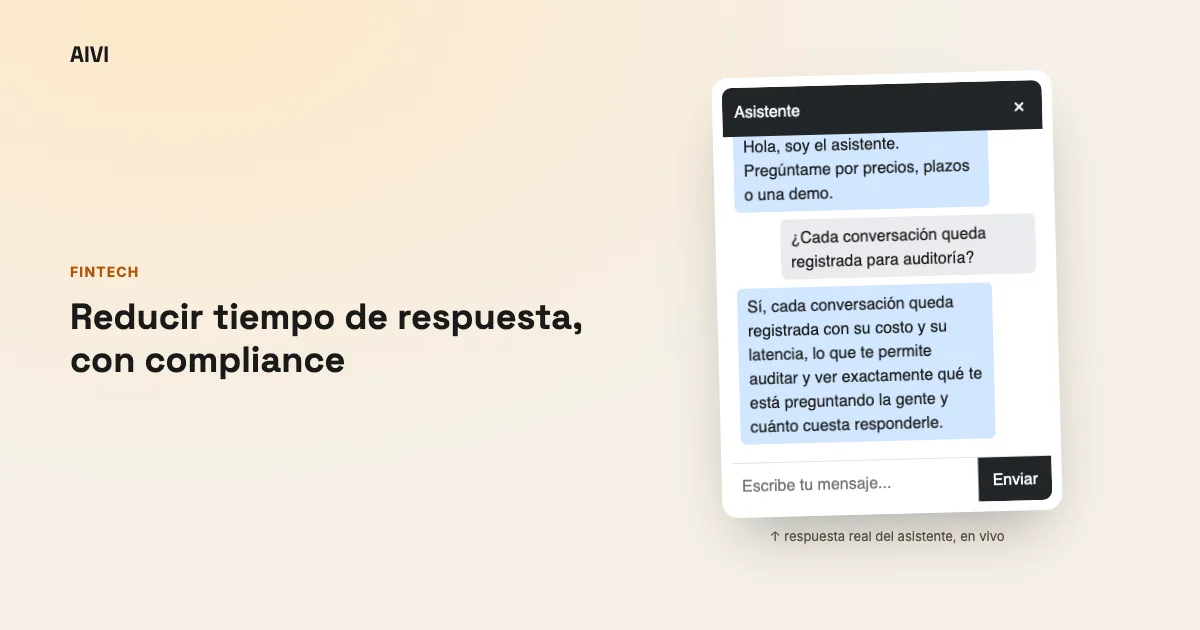
¿Cada conversación queda registrada para auditoría?
Sí, con su costo y contenido completo, consultable en un reporte.
¿Qué pasa si un cliente pregunta algo sobre su cuenta específica?
El asistente lo reconoce como fuera de lo que puede responder y lo escala de inmediato, sin intentar adivinar.
¿Reduce de verdad la carga del equipo, o solo la disfraza?
Solo lo que es genuinamente repetitivo y público se automatiza — el objetivo es medible: menos tickets de bajo valor, no menos visibilidad de los que sí importan.
¿Se puede empezar solo con un proceso, no con todo el soporte?
Sí, de hecho es lo recomendado — automatizar un proceso bien definido y medir antes de escalar a más.
¿Quieres identificar qué parte de tu atención hoy es puramente repetitiva? Agenda un diagnóstico gratuito.